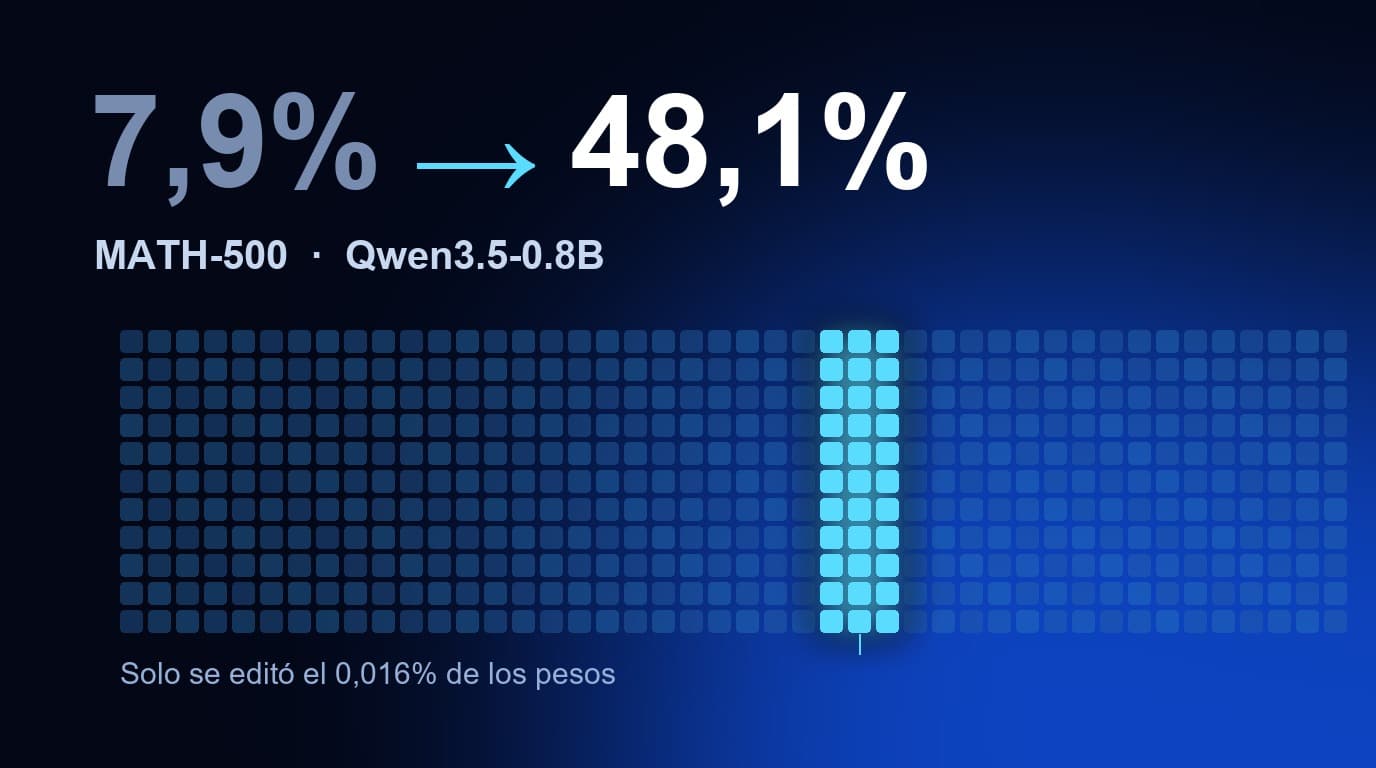

Un modelo de lenguaje abrió los pesos de otro modelo, encontró la dirección que lo hacía entrar en bucles y la restó. En total cambió 131.072 pesos, el 0,016% de Qwen3.5-0.8B, y la nota del modelo en MATH-500 pasó del 7,9% al 48,1%. No hubo entrenamiento ni gradientes.
El resultado viene del post "Sparks of Weight-Space Programming", firmado por Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab, de MIT CSAIL, y publicado el 2 de noviembre de 2026. El tweet que lo resume superó los 5 millones de visualizaciones en su primer día. Las cifras de este artículo son las de los autores: no las hemos replicado y el propio post las describe como resultados tempranos.
1. ¿Qué es la programación en el espacio de pesos?
Es la idea de que un modelo de lenguaje general lea y escriba directamente los pesos de otra red neuronal, guiado por un objetivo en lenguaje natural y sin optimizador. Los autores la llaman Weight-Space Programming. El modelo que usaron aparece en el post como GPT-6 Astra.
El post recoge ocho experimentos. Cuatro leen pesos (identificar a qué juega una red o en qué idioma escribe) y cuatro los escriben o los corrigen. El más citado es el de Qwen3.5-0.8B, que es el que importa a una empresa que ejecuta modelos pequeños en sus propios servidores.
2. Qué hicieron con Qwen3.5-0.8B
El modelo de partida tiene 24 capas y 0.8B de parámetros, con el modo de razonamiento activado. Astra trabajó en un kernel de Python sobre los pesos, sin GPU, con problemas de práctica de los conjuntos de entrenamiento de GSM8K (7.469) y MATH (7.275). Tenía un presupuesto de 10, 25 o 50 pasadas hacia delante, y cada pasada permitía al modelo responder hasta 512 problemas.
El modelo base entra en bucles: de sus primeras 96 respuestas de práctica, 85 llegaron al límite de 32.768 tokens. Astra rastreó el bucle hasta una dirección que escriben las MLP de las capas 15 y 19, y la restó de 64 columnas de salida en cada una. Son 131.072 pesos de un total de 0.8B.
El post cita además que la ficha del modelo de Qwen ya avisa de este comportamiento de bucles en razonamiento.
3. Los resultados, con su presupuesto de pasadas
Mismos ajustes de muestreo en todas las filas (temperatura 0,6, top-p 0,95, top-k 20, hasta 32.768 tokens):
| Qwen3.5-0.8B | MATH-500 (%) | GSM8K (%) | IFEval (%) | Respuestas que agotan el límite (%) |
|---|---|---|---|---|
| Base | 7,9 | 13,8 | 21,0 | 93,0 |
| Editado, 10 pasadas | 12,3 | 25,7 | 49,0 | 87,2 |
| Editado, 25 pasadas | 14,1 | 25,1 | 39,9 | 86,4 |
| Editado, 50 pasadas | 48,1 | 67,1 | 62,3 | 33,1 |
La mejora grande llega con 50 pasadas. Con 10 y 25, MATH-500 sube a 12,3% y 14,1%. IFEval, que mide seguimiento de instrucciones, mejora más de tres veces sin que la edición apuntara a él, porque los bucles afectan a cualquier tarea.
4. Qué no demuestra el experimento
Los autores son claros sobre los límites, y conviene leerlos antes de sacar conclusiones:
- Arreglar bucles no es lo mismo que mejorar el razonamiento matemático. La edición deja que el modelo termine respuestas que ya sabía resolver.
- En Gemma 3 270M, que casi no entra en bucles (el 8,5% de sus respuestas llega al límite, frente al 93% de Qwen), Astra no consiguió mejorar nada. MATH-500 pasó de 6,8% a entre 7,0% y 7,7% según el presupuesto, una variación de menos de un punto.
- Los fallos de Gemma eran errores de cálculo y pasos algebraicos inválidos, sin un componente concreto que apagar. De ahí la conclusión del post: editar pesos puede quitar un obstáculo que esconde una capacidad, pero no crea una capacidad que el modelo no tiene.
- Varios experimentos son de un solo intento o una sola respuesta, como la corrección de la política de control (Kinetix) y la escritura de pesos desde cero.
- Los autores preparan un benchmark y un arnés para el método. Todavía no están publicados.
5. Otros resultados del post
Tres experimentos ayudan a calibrar hasta dónde llega la idea:
- Escribir pesos desde cero: con una red 600→32→32→6 inicializada a cero, Astra escribió los pesos en una sola respuesta para jugar a MinAtar Breakout. Obtuvo 517,4 puntos, frente a 25,3 de PPO entrenado durante 500 millones de pasos. En Seaquest (53,1 frente a 88,9) y Asterix (53,2 frente a 55,2) quedó por debajo o a la par de PPO a 500M.
- Leer pesos: a partir de las capas centrales de tres transformers de 7,16M de pesos, sin etiquetas, Astra acertó el idioma (Python, romaji, inglés) y señaló las cabezas de copia que luego se confirmaron ejecutando el modelo.
- Detectar adulación: solo con los pesos de dos copias de Gemma 3 270M, una honesta y otra aduladora, Astra falló en los cuatro intentos. Cuando pudo ver patrones de atención sobre textos que escribió él mismo, identificó la aduladora en los tres pares.
6. Qué significa para una pyme
Lo que sigue es nuestra lectura, no una conclusión del post.
Primero, el diagnóstico antes que la compra. Si tu modelo local da respuestas malas, mide qué porcentaje de ellas llega al límite de tokens. En Qwen ese número (93%) explicaba casi todo. Un modelo cuyo problema son los bucles necesita una corrección, no un modelo más grande ni un servidor nuevo.
Segundo, el coste cambia de naturaleza. El flujo del post no entrena ni usa GPU para editar, pero sí ejecuta el modelo decenas de veces para comprobar los cambios. El gasto pasa del entrenamiento a la inferencia y a un modelo de razonamiento potente que dirija el proceso. Ese modelo es de pago, y el post no indica cómo acceder a GPT-6 Astra.
Tercero, hoy no hay herramienta que puedas instalar. Código y logs de los experimentos son públicos, pero el arnés y el benchmark no, y los resultados dependen de un modelo que quizá no puedas usar. Para un proyecto de producción esta semana, la opción realista sigue siendo elegir bien el modelo, ajustar el muestreo y medir.
Cuarto, la dirección merece seguimiento. Si editar pesos con un modelo general se vuelve fiable, un modelo pequeño con un defecto concreto podría arreglarse en horas y sin repetir un fine-tuning. Con datos propios y modelos que corren dentro de tu red, eso reduciría el coste de mantener IA local. Hoy es una hipótesis que los autores también describen como creencia, no como resultado.
Qué hacer esta semana
Mide en tus pruebas actuales el porcentaje de respuestas que se cortan por límite de tokens y las que repiten texto. Si una parte relevante de las respuestas se corta o se repite, revisa primero los ajustes de muestreo que indica la ficha del modelo y el límite de tokens. Si el problema persiste en un modelo concreto, guarda ese caso con ejemplos: es el tipo de fallo que este método podría atacar cuando el arnés esté disponible.
Reserva tu sesión de consultoría técnica de 60 minutos aquí y revisamos qué modelo, qué hardware y qué ajustes encajan con tu caso de uso hoy, con herramientas que ya existen.
Preguntas frecuentes
¿Es cierto que una IA mejoró otra IA sin entrenarla?
Según los autores, sí: Astra editó 131.072 pesos de Qwen3.5-0.8B (0,016%) sin gradientes ni entrenamiento, y MATH-500 pasó de 7,9% a 48,1% con 50 pasadas hacia delante. Es un resultado de un solo grupo, descrito como temprano. Los logs completos están publicados en GitHub para que otros lo revisen.
¿Puedo hacer esto con el modelo de mi empresa?
Hoy no. El método usa un modelo de razonamiento muy potente (GPT-6 Astra en el post) y un arnés que los autores todavía no han publicado. Sí puedes aplicar la idea de diagnóstico: medir cuántas respuestas de tu modelo acaban en bucle o cortadas por límite de tokens.
¿Sirve para modelos que ya funcionan bien?
El post indica que no. En Gemma 3 270M, que rara vez entra en bucles, Astra no mejoró las matemáticas. La edición de pesos resolvió un defecto concreto de Qwen, no añadió capacidad.
¿Qué es un bucle de razonamiento?
Es cuando un modelo con modo de razonamiento repite el mismo texto y no llega a una respuesta final. En Qwen3.5-0.8B, 85 de las primeras 96 respuestas de práctica agotaron los 32.768 tokens permitidos. La ficha del modelo ya advierte de este comportamiento.
¿Debo cambiar mi estrategia de IA por este resultado?
No. Es una línea de investigación que conviene seguir, con resultados prometedores y límites declarados. Para decidir hoy, usa modelos publicados, mide con tus propios casos y revisa la estrategia cuando el método esté disponible y alguien lo haya replicado.