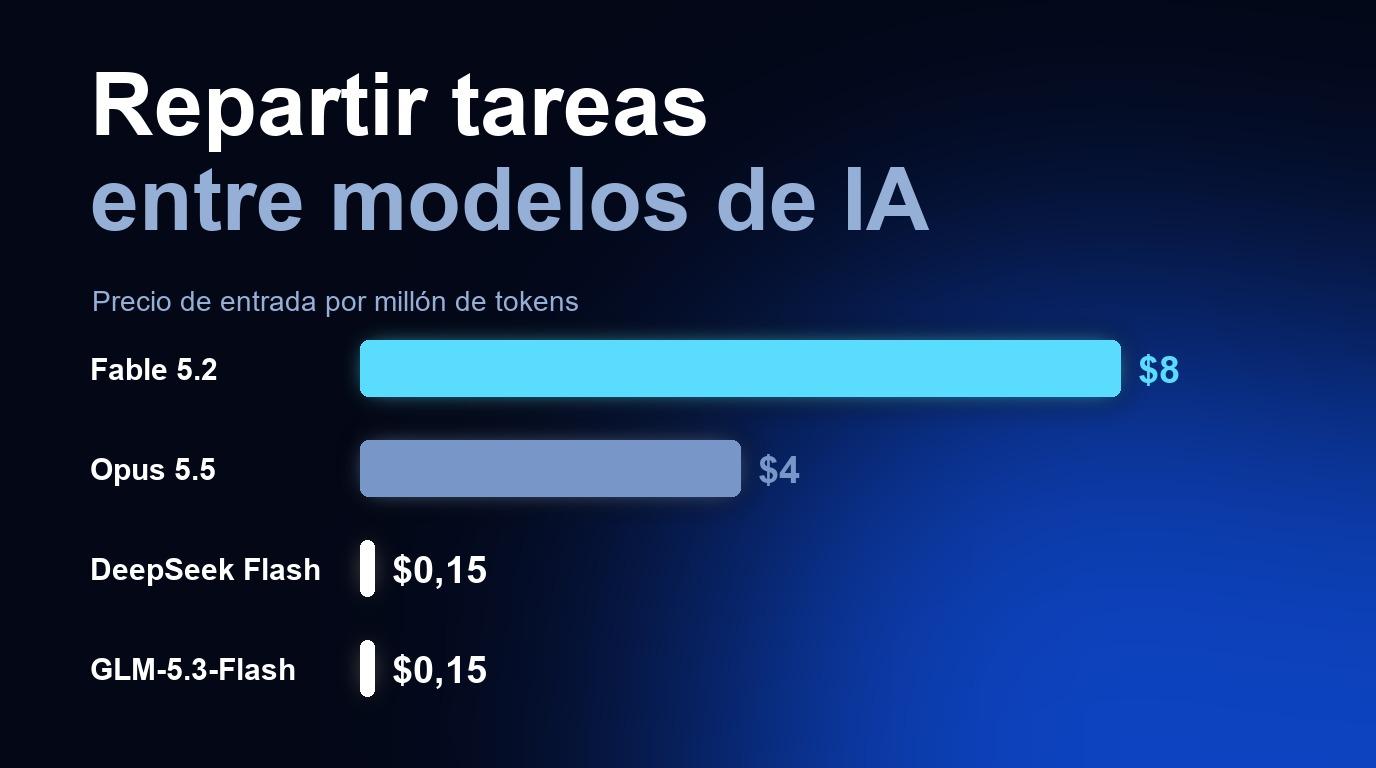

Claude Fable 5.2 cuesta 8 dólares por millón de tokens de entrada y 40 de salida. DeepSeek Flash cuesta 0,15 y 0,60 en horario valle, y GLM-5.3-Flash, 0,15 y 0,50. Por token de entrada, Fable 5.2 es unas 53 veces más caro que cualquiera de los dos, y por token de salida, entre 67 y 80 veces.
Esa diferencia no significa que un modelo barato valga para todo. Significa que pagar siempre el modelo más caro, para cualquier tarea, es una decisión que conviene medir. La alternativa se llama enrutado de modelos: cada tarea va primero a un modelo barato y solo sube a uno caro cuando hace falta. Este artículo recoge los precios oficiales, lo que dice la investigación sobre el enrutado, un ejemplo de factura y un método para aplicarlo. Casi al final mencionamos un servicio de tarifa plana con un enlace de recomendación de IA4PYMES, y lo señalamos donde aparece.
1. ¿Cuánto cuesta cada modelo?
Precios por millón de tokens, tomados de las páginas oficiales de cada proveedor:
| Modelo | Entrada | Salida | Fuente |
|---|---|---|---|
| Claude Fable 5.2 | 8 $ | 40 $ | Anthropic |
| Claude Opus 5.5 | 4 $ | 20 $ | Documentación de Anthropic |
| DeepSeek Flash, horario valle | 0,15 $ | 0,60 $ | DeepSeek |
| DeepSeek Flash, horario punta | 0,30 $ | 1,20 $ | DeepSeek |
| GLM-5.3-Flash | 0,15 $ | 0,50 $ | Z.ai |
Tres detalles que cambian la cuenta:
- DeepSeek cobra el doble en horas punta. Según su documentación, son de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes y excepto festivos públicos chinos. En hora peninsular de invierno equivale a de 02:00 a 05:00 y de 07:00 a 11:00. Las tareas por lotes que se ejecutan de noche o en fin de semana se benefician del precio valle. Analizamos el cambio de tarifas en nuestro artículo sobre la subida de precios de DeepSeek V4-Pro.
- El nombre del modelo de DeepSeek varía. La documentación de DeepSeek usa el identificador deepseek-flash y lista la versión DeepSeek-V4.1-Flash-1017. Los nombres antiguos, como deepseek-v4-flash, siguen aceptándose, pero DeepSeek indica que los modelos correspondientes están retirados. Contexto de 1M de tokens y hasta 384K de salida.
- GLM-5.3-Flash tiene 320.000 millones de parámetros, 18.000 millones activos, 1M de contexto y hasta 128K de salida, según la documentación de Z.ai. En Hugging Face figura con licencia MIT. Antes de redistribuirlo o usarlo en un producto, lee el archivo de licencia del repositorio.
Estos son precios de lista de la API de cada proveedor. No incluyen descuentos por caché ni por lotes, que existen en varios de ellos.
2. ¿Qué dicen los datos sobre la calidad?
La respuesta honesta es que no hay una comparación independiente y limpia de estos modelos en tareas de oficina. Lo que existe son cifras de cada proveedor:
- Z.ai informa de que GLM-5.3-Flash obtiene 63,4 en DeepSWE v1.1 (frente a 46,2 de GLM-5.2) y 48,8 en AutomationBench (frente a 26,2 de GLM-5.2).
- La tabla de Anthropic lista en AutomationBench un 51,4% para Fable 5.2, un 42,5% para Opus 5.5 y un 53,9% para Gemini 4 Carbon.
Tomadas a la vez, esas cifras sugieren que un modelo Flash puede quedar cerca de un modelo de frontera en esa prueba. Dos cautelas lo limitan: cada número lo publica un proveedor distinto y no podemos confirmar que usen la misma versión ni la misma configuración de AutomationBench. No incluimos cifras de DeepSeek Flash porque no hemos contrastado ninguna en una fuente oficial.
La conclusión práctica es la misma de siempre: la única comparación que vale es la que haces con tus propios documentos.
3. Qué dice la investigación sobre el enrutado
Dos trabajos académicos miden cuánto se ahorra cuando una pasarela decide qué modelo usar para cada consulta:
- RouteLLM (LMSYS, 2024) enruta entre GPT-4 Turbo como modelo fuerte y Mixtral 8x7B como modelo débil. Según su blog, logra reducciones de coste de más del 85% en MT Bench, del 45% en MMLU y del 35% en GSM8K frente a usar solo GPT-4, conservando el 95% de su rendimiento. Con otro baseline, un enrutador aleatorio, el mejor enrutador alcanza el 95% del rendimiento llamando a GPT-4 en el 26% de los casos, con un coste cerca de un 48% menor.
- FrugalGPT (2023) afirma en su resumen que puede igualar el rendimiento del mejor modelo individual con una reducción de coste de hasta el 98%, o mejorar la precisión de GPT-4 un 4% al mismo coste.
Las cautelas pesan tanto como las cifras. Son estudios de 2023 y 2024 con modelos anteriores. En RouteLLM, los enrutadores entrenados solo con datos de Arena rindieron casi al azar en MMLU, y hizo falta aumentar los datos con etiquetas correctas. El coste se mide por número de llamadas al modelo caro. Y el 85% de MT Bench no se repite en las otras pruebas.
Lo que sí demuestran es el mecanismo: cuando las consultas varían en dificultad, repartirlas ahorra dinero. Cuánto ahorra en tu caso solo lo sabes midiendo.
4. Cómo repartir las tareas
Este cuadro recoge nuestro criterio de partida, no una norma:
| Tipo de tarea | Modelo de partida | Cuándo subir de modelo |
|---|---|---|
| Clasificar correos, extraer campos de facturas, formatear datos | Flash | Si falla la validación de campos |
| Resumir documentos y reuniones | Flash | Si el documento es largo o ambiguo |
| Redactar respuestas a clientes | Flash, con revisión humana | Si el tono o el contexto son delicados |
| Analizar contratos o documentos con matices | Opus 5.5 | Casos de alto impacto, con revisión de una persona |
| Agentes que trabajan durante horas, código complejo | Opus 5.5 o Fable 5.2 | Anthropic recomienda empezar por Opus 5.5 |
El método tiene tres pasos:
- Etiqueta tus tareas por dificultad y por coste de un error. Un correo mal clasificado cuesta poco, una factura mal contabilizada, bastante más.
- Prueba entre 20 y 50 casos reales con un modelo barato y con uno caro. Puntúa si el resultado es correcto, cuánto tarda y cuánto cuesta.
- Define la regla de subida. El modelo barato responde primero y la tarea sube al caro cuando falla una validación automática (formato, importes, campos obligatorios), cuando el modelo indica baja confianza o cuando el tipo de tarea lo exige.
Las validaciones automáticas son la parte más barata y más útil del sistema. Una factura cuyo total no cuadra con la suma de sus líneas no necesita un modelo más caro para detectar el error. Necesita una regla.
5. Un ejemplo de factura
Cálculo ilustrativo con supuestos nuestros: 20.000 documentos al mes, 3.000 tokens de entrada y 500 de salida cada uno, es decir, 60 millones de tokens de entrada y 10 millones de salida. Sin caché ni lotes.
| Estrategia | Coste mensual |
|---|---|
| Todo con Fable 5.2 | 880 $ |
| Todo con Opus 5.5 | 440 $ |
| Todo con DeepSeek Flash (valle / punta) | 15 $ / 30 $ |
| Todo con GLM-5.3-Flash | 14 $ |
| Enrutado: 90% a DeepSeek Flash y 10% a Opus 5.5 | entre 57,50 $ y 71 $ |
El enrutado del ejemplo cuesta más de un 80% menos que enviar todo a Opus 5.5 y más de un 90% menos que enviar todo a Fable 5.2. El reparto 90/10 es un supuesto, no un dato. Si en tus pruebas el modelo barato resuelve el 70% de los casos, la factura sube. El cálculo tampoco incluye el tiempo de montar y mantener el enrutado, ni las llamadas repetidas cuando una tarea sube de modelo. Con esos costes, el ahorro sigue pesando, pero menos que la cifra bruta.
La misma lógica aparece en nuestro artículo anterior sobre el FOMO del modelo más caro. Aquí añadimos precios actuales y un método de reparto.
6. La alternativa de la tarifa plana: NaN Builders
Pagar por token da una factura que varía con el uso. Una tarifa plana la fija de antemano. NaN Builders es un servicio de inferencia de modelos abiertos con cuota mensual. Según su página oficial:
- Cuota mensual fija: el plan con inferencia incluida cuesta 70 € al mes, IVA incluido, y da una clave de API personal compatible con OpenAI, así que basta con cambiar la dirección base en tus herramientas.
- Modelos abiertos: entre otros, DeepSeek V4.1 Flash y GLM-5.3-Flash, además de modelos de embeddings, reranking y voz.
- Privacidad: su política de privacidad, actualizada el 14 de octubre de 2026, afirma que el clúster no guarda ni los prompts ni las respuestas, que el procesamiento ocurre en la Unión Europea y que tu código no entrena modelos. Son declaraciones de la propia empresa.
Una tarifa plana compensa cuando el volumen es alto o difícil de prever y los límites de uso del plan no te frenan. Para decidir si te compensa, haz la prueba del apartado 4 con su API y compara el coste por tarea con el de pagar por token.
Queremos ser transparentes: este es un enlace de recomendación de IA4PYMES. Hemos probado NaN Builders y lo recomendamos muchísimo por su calidad. Si te suscribes con este enlace de invitación a NaN Builders, tienes 5 € de descuento en la primera mensualidad. Revisa las condiciones en su web antes de pagar. Hicimos un análisis más amplio del servicio en nuestro artículo sobre NaN Builders.
Una consideración de privacidad vale para cualquier opción. Antes de enviar datos personales de clientes o empleados a la API de un proveedor, comprueba dónde se procesan y cuánto tiempo se conservan.
Qué hacer esta semana
Elige tres tareas que hoy ejecutes con un modelo de frontera: la que más tokens consume, la más sencilla y la más delicada. Pásalas con 20 casos reales por un modelo Flash y por el modelo que usas ahora, y puntúa acierto, tiempo y coste. Si el modelo barato acierta en las dos primeras, enruta esas tareas y deja el modelo caro para la tercera. Y añade una validación automática antes de cada paso para detectar errores sin pagar más.
Reserva tu sesión de consultoría técnica de 60 minutos aquí y diseñamos contigo el reparto de modelos para tu caso, con una prueba sobre tus propios datos.
Preguntas frecuentes
¿Qué es el enrutado de modelos de IA?
Es un sistema que decide, para cada tarea o consulta, qué modelo la procesa. Lo habitual es que un modelo barato responda primero y que la tarea suba a uno más caro cuando falla una validación, la confianza es baja o el tipo de tarea lo exige. Estudios como RouteLLM y FrugalGPT miden el ahorro que se consigue.
¿Cuánto más barato es DeepSeek Flash que Claude Fable 5.2?
Según los precios de lista, Fable 5.2 cuesta 8 dólares de entrada y 40 de salida por millón de tokens. DeepSeek Flash cuesta 0,15 y 0,60 en horario valle y el doble en horas punta. Por token de entrada, la diferencia es de unas 53 veces en horario valle y unas 27 en horas punta. La diferencia de precio no mide la diferencia de calidad.
¿Es GLM-5.3-Flash de código abierto?
En Hugging Face figura con licencia MIT y pesos descargables, con 320.000 millones de parámetros y 18.000 millones activos. Lee el archivo de licencia del repositorio antes de usarlo en un producto. La API de Z.ai cuesta 0,15 dólares de entrada y 0,50 de salida por millón de tokens.
¿Sirve un modelo barato para tareas reales de una empresa?
Para muchas tareas acotadas, como clasificar, extraer campos o resumir, es razonable probarlo primero. No hay una comparación independiente concluyente para tareas de oficina, así que la decisión se toma con tus propios documentos, con un conjunto de 20 a 50 casos y una validación automática del resultado.
¿Merece la pena una tarifa plana de inferencia?
Depende de tu volumen y de lo previsible que sea. Una cuota fija da una factura conocida, pero el plan tiene límites de uso. Compara el coste por tarea de tus pruebas con el de pagar por token antes de decidir.