
Alibaba abrió el 16 de noviembre de 2026 el acceso general a Qwen4-Max. Según el anuncio de Alibaba Cloud, el modelo tiene 2,4 billones de parámetros y activa 71.000 millones por token. Admite hasta 1 millón de tokens de contexto y cuesta 1,50 dólares por millón de tokens de entrada y 4,50 de salida en la región de Singapur. Los pesos no se publican: solo se usa a través de la API de Alibaba.
Este artículo separa lo que Alibaba afirma en su documentación de lo que cuentan terceros, calcula qué supone el precio para una factura típica de pyme y analiza dos cuestiones que cualquier empresa española debería mirar antes de probarlo: dónde se procesan los datos y para qué tareas puede tener sentido. Cuando una cifra viene de una fuente secundaria, lo indicamos en la misma frase.
1. ¿Qué ha lanzado Alibaba exactamente?
Estos datos salen de la documentación de Alibaba Cloud sobre qwen4-max, de su registro de lanzamientos y del anuncio oficial:
| Dato | Valor |
|---|---|
| Fechas | Vista previa el 11 de noviembre (solo mediante Token Plan). Disponibilidad general el 16 de noviembre, con el identificador qwen4-max |
| Parámetros | 2,4 billones en total, 71.000 millones activos por token. Alibaba indica un 25% menos de parámetros activos que Qwen3.8-Max |
| Contexto | 1.000.000 de tokens. Entrada máxima de 991.808 sin razonamiento y 983.616 con razonamiento |
| Salida máxima | 131.072 tokens sin razonamiento y 262.144 con razonamiento |
| Entradas y salidas | Entra texto, imagen y vídeo. Sale texto |
| Funciones | Razonamiento, búsqueda web, llamadas a funciones, salida estructurada y caché de contexto |
| No admite | Inferencia por lotes ni ajuste fino |
| Pesos | Cerrados. Alibaba dice que pronto publicará modelos de la serie Qwen4 de menor tamaño con pesos abiertos, sin fecha ni tamaños |
Un matiz de nomenclatura: el nombre oficial es Qwen4-Max. En la prensa aparece también como Qwen 4 Max. Es un modelo distinto del Qwen3.8-2.4T-A95B, que Alibaba publicó en agosto con pesos abiertos.
2. ¿Cuánto cuesta?
La página de precios de Alibaba Model Studio lista una sola franja de precio, hasta 1M de tokens, sin tramos por longitud de contexto. Precios por millón de tokens, según la página oficial de precios:
| Región | Entrada | Salida | Lectura de caché |
|---|---|---|---|
| Singapur (internacional) | 1,50 $ | 4,50 $ | 0,075 $ |
| Frankfurt, Pekín, Hong Kong, EE. UU. (Virginia), Tokio | 1,413 $ | 4,24 $ | 0,071 $ |
La lectura de caché cuesta el 5% del precio normal de entrada. Si haces muchas preguntas sobre el mismo documento largo, ese detalle pesa más que la tarifa base. Alibaba ofrece además 1 millón de tokens gratis durante 90 días en la región de Singapur.
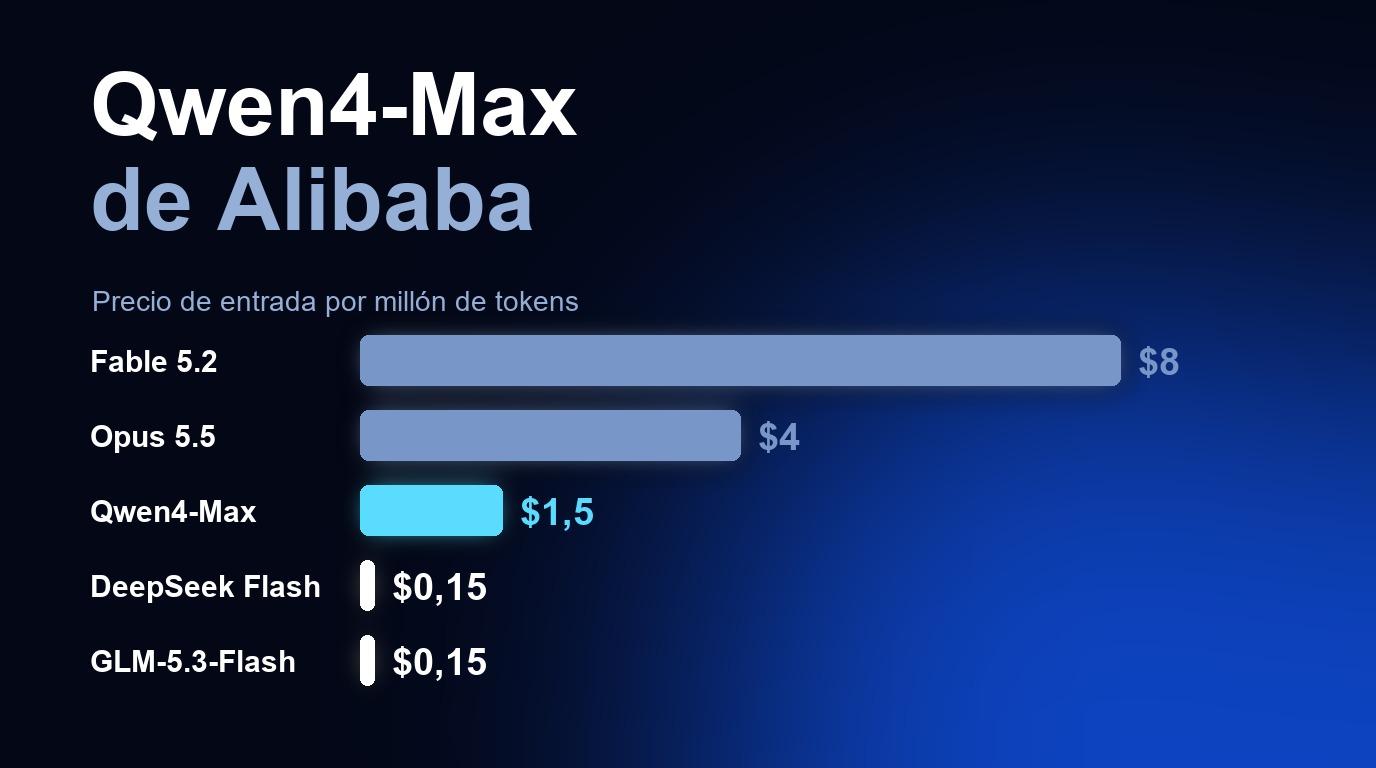
Para ponerlo en perspectiva, la tabla compara el precio con los modelos de nuestro artículo sobre enrutado de modelos, todos a precio de lista:
| Modelo | Entrada | Salida |
|---|---|---|
| Claude Fable 5.2 | 8 $ | 40 $ |
| Claude Opus 5.5 | 4 $ | 20 $ |
| Qwen4-Max (Singapur) | 1,50 $ | 4,50 $ |
| DeepSeek Flash (valle) | 0,15 $ | 0,60 $ |
| GLM-5.3-Flash | 0,15 $ | 0,50 $ |
Por token de entrada, Qwen4-Max cuesta alrededor de un 81% menos que Fable 5.2 y un 63% menos que Opus 5.5. Es unas diez veces más caro que los modelos Flash. Por token de salida, la diferencia con Fable 5.2 es de casi nueve veces.
Un ejemplo de factura
Aplicamos el mismo supuesto de aquel artículo: 20.000 documentos al mes, 3.000 tokens de entrada y 500 de salida cada uno, es decir, 60 millones de tokens de entrada y 10 millones de salida, sin caché ni lotes.
| Estrategia | Coste mensual |
|---|---|
| Todo con Fable 5.2 | 880 $ |
| Todo con Opus 5.5 | 440 $ |
| Todo con Qwen4-Max (Singapur) | 135 $ |
| Todo con Qwen4-Max (Frankfurt) | 127,18 $ |
| Todo con DeepSeek Flash (valle) | 15 $ |
El cálculo tiene un límite importante. Alibaba documenta hasta 262.144 tokens de razonamiento por respuesta, y no hemos verificado cómo se facturan. Si activas el razonamiento y el modelo genera miles de tokens por tarea, la salida real será mucho mayor que los 500 tokens del ejemplo. Mide el coste de una llamada real con el razonamiento activado antes de extrapolar.
3. ¿Qué dicen los datos sobre su calidad?
Aquí hay que ser prudentes. El anuncio de Alibaba no incluye cifras de benchmarks ni compara el modelo con Claude, GPT o Gemini. Lo que sí afirma:
- Menor coste por tarea. En Work360, un benchmark propietario de Alibaba con 721 campos profesionales, el coste medio por tarea baja alrededor de un 60% frente a Qwen3.8-Max, y usa un 35% menos de tokens con esfuerzo alto. La comparación es contra el modelo anterior de la propia Alibaba y sobre una prueba que no es pública.
- Posición en Code Arena. Alibaba dice que queda sexto.
Las cifras con competidores salen de DataCamp, que reproduce la gráfica de Alibaba (no pudimos leer la imagen original). Según DataCamp, en Terminal-Bench 4.0 Qwen4-Max marca 48,5 y Kimi K3.1 marca 67,2. Cita también dos clasificaciones independientes: el Artificial Analysis Intelligence Index lo sitúa novena, con 43 puntos, y Vals AI lo sitúa en el puesto 11 de 38. Son cifras de una fuente secundaria que no hemos contrastado con las páginas originales.
Los datos de DataCamp difieren en detalles de lo que publica Alibaba. Por ejemplo, DataCamp habla de una reducción del 62% en el coste por tarea y Alibaba habla de alrededor del 60%. Cuando hay diferencias, nos quedamos con la cifra de Alibaba.
Como en otros lanzamientos, hay un modelo nuevo con cifras favorables publicadas por su fabricante y pocas comparaciones independientes. Para una tarea concreta de tu empresa, la única referencia fiable es una prueba con tus propios documentos.
4. ¿Qué cambia para una pyme?
Un candidato para el escalón intermedio
Con un enrutado de modelos, cada tarea va primero a un modelo barato y sube a uno caro cuando falla una validación. Qwen4-Max cuesta menos de la mitad que Opus 5.5 y diez veces más que un modelo Flash. Usarlo como escalón intermedio es una hipótesis razonable: para las tareas que un Flash no resuelve y que no justifican pagar el precio de Opus o Fable. Nadie ha publicado una comparación independiente sobre tareas de oficina, y por eso la prueba del apartado 6 es obligatoria.
Documentos largos y entrada multimodal
Con 1 millón de tokens de contexto y entrada de imagen y vídeo, cabe en una sola llamada un contrato extenso con anexos, un manual técnico o un conjunto de facturas escaneadas. Una llamada con el contexto lleno cuesta 1,50 dólares de entrada en Singapur. Con la caché, las preguntas siguientes sobre el mismo documento cuestan una fracción. Antes de enviar un documento así, comprueba la calidad de las respuestas: un contexto largo permite meter mucho texto, y la precisión sobre él hay que medirla.
Lo que no tiene
La API no admite inferencia por lotes ni ajuste fino. El primero es el descuento habitual en procesos nocturnos, y el segundo es una vía para adaptar un modelo a tu terminología. Si tu caso depende de alguno, Qwen4-Max hoy no lo cubre.
Pesos cerrados y modelos pequeños en camino
Qwen4-Max no se puede descargar ni ejecutar en tus servidores. Alibaba anuncia modelos abiertos de la serie Qwen4 de menor tamaño sin dar fecha. Si tu prioridad es ejecutar IA en local, esa es la noticia relevante y todavía no existe. Mientras tanto, tienes opciones abiertas actuales, como Qwen3.8 27B, que explicamos en nuestro artículo para descargarlo y ejecutarlo en local. Sobre qué sabíamos antes del lanzamiento, tienes nuestro análisis de Qwen 4 y el nombre en clave Kalmia.
5. Privacidad: dónde se procesan tus datos
Es la pregunta que más importa a una empresa española y la que la documentación deja menos clara.
- Frankfurt aparece como región con precio propio, pero en la documentación de Alibaba su alcance de despliegue figura como Global. Otros modelos de Alibaba, como qwen-plus, tienen una fila separada de alcance UE. No encontramos una declaración de residencia de datos para qwen4-max.
- La región de Singapur, la que da la cuota gratuita, procesa fuera de la UE.
- Los pesos son cerrados, así que no puedes llevarte el modelo a tu infraestructura para controlar el tratamiento.
Antes de enviar datos personales de clientes o empleados, pide por escrito a Alibaba Cloud dónde se procesan, cuánto tiempo se conservan y qué contrato de encargado de tratamiento ofrecen. Mientras tanto, usa solo datos sin información personal en las pruebas. Sobre cómo valorar el envío de datos a un proveedor de IA, tienes nuestra guía de RGPD para subir datos de clientes a un modelo.
6. Cómo probarlo esta semana
- Elige tres tareas que hoy hagas con un modelo de frontera: la que más tokens consume, la más sencilla y la más delicada.
- Prepara entre 20 y 50 casos reales sin datos personales. Anonimízalos o usa ejemplos sintéticos.
- Pásalos por tres modelos: el que usas ahora, un modelo Flash y Qwen4-Max. Puedes usar la cuota gratuita de 1 millón de tokens, solo con esos datos no personales.
- Puntúa tres cosas: si el resultado es correcto, cuánto tarda y cuánto cuesta cada tarea, con el razonamiento activado y sin él.
- Añade validaciones automáticas (formato, importes, campos obligatorios) antes de decidir cuándo sube una tarea de modelo.
Si Qwen4-Max acierta donde el Flash falla, y lo hace por menos dinero que tu modelo actual, tienes el escalón intermedio. Si no, la prueba te habrá costado unas pocas llamadas.
Reserva tu sesión de consultoría técnica de 60 minutos aquí y montamos contigo la prueba con tus propios documentos, con el reparto de modelos y la revisión de privacidad incluidos.
Preguntas frecuentes
¿Qué es Qwen4-Max?
Es un modelo de lenguaje multimodal de Alibaba, con 2,4 billones de parámetros totales y 71.000 millones activos por token, que admite 1 millón de tokens de contexto y entrada de texto, imagen y vídeo. Alibaba abrió el acceso general por API el 16 de noviembre de 2026.
¿Cuánto cuesta Qwen4-Max?
En la región de Singapur, 1,50 dólares por millón de tokens de entrada y 4,50 de salida. En Frankfurt, Pekín, Hong Kong, EE. UU. (Virginia) y Tokio, 1,413 y 4,24 dólares. La lectura de caché cuesta 0,075 y 0,071 dólares respectivamente. No hay tramos por longitud de contexto.
¿Es de código abierto?
No. Qwen4-Max es un modelo cerrado que solo se usa por API. Alibaba ha dicho que publicará pronto modelos de la serie Qwen4 de menor tamaño con pesos abiertos, sin fechas ni tamaños.
¿Se procesan los datos en Europa?
La documentación lista una región de Frankfurt con precio propio, pero con alcance Global, y no encontramos una declaración de residencia de datos para este modelo. Antes de enviar datos personales, pide a Alibaba Cloud confirmación escrita del lugar de procesamiento y del contrato de tratamiento.
¿Es mejor que Claude, GPT o Gemini?
No hay datos suficientes para decirlo. El anuncio de Alibaba no compara el modelo con esos competidores. Según DataCamp, un modelo de la competencia puntúa más alto en Terminal-Bench 4.0, y Artificial Analysis lo sitúa novena en su índice. Tus propios documentos son la prueba válida.
¿Para qué tareas de una pyme puede servir?
Para tareas que un modelo Flash no resuelve y que no justifican el precio de un modelo de frontera, como analizar documentos largos o resolver casos ambiguos. Es una hipótesis que hay que comprobar con una prueba propia.